
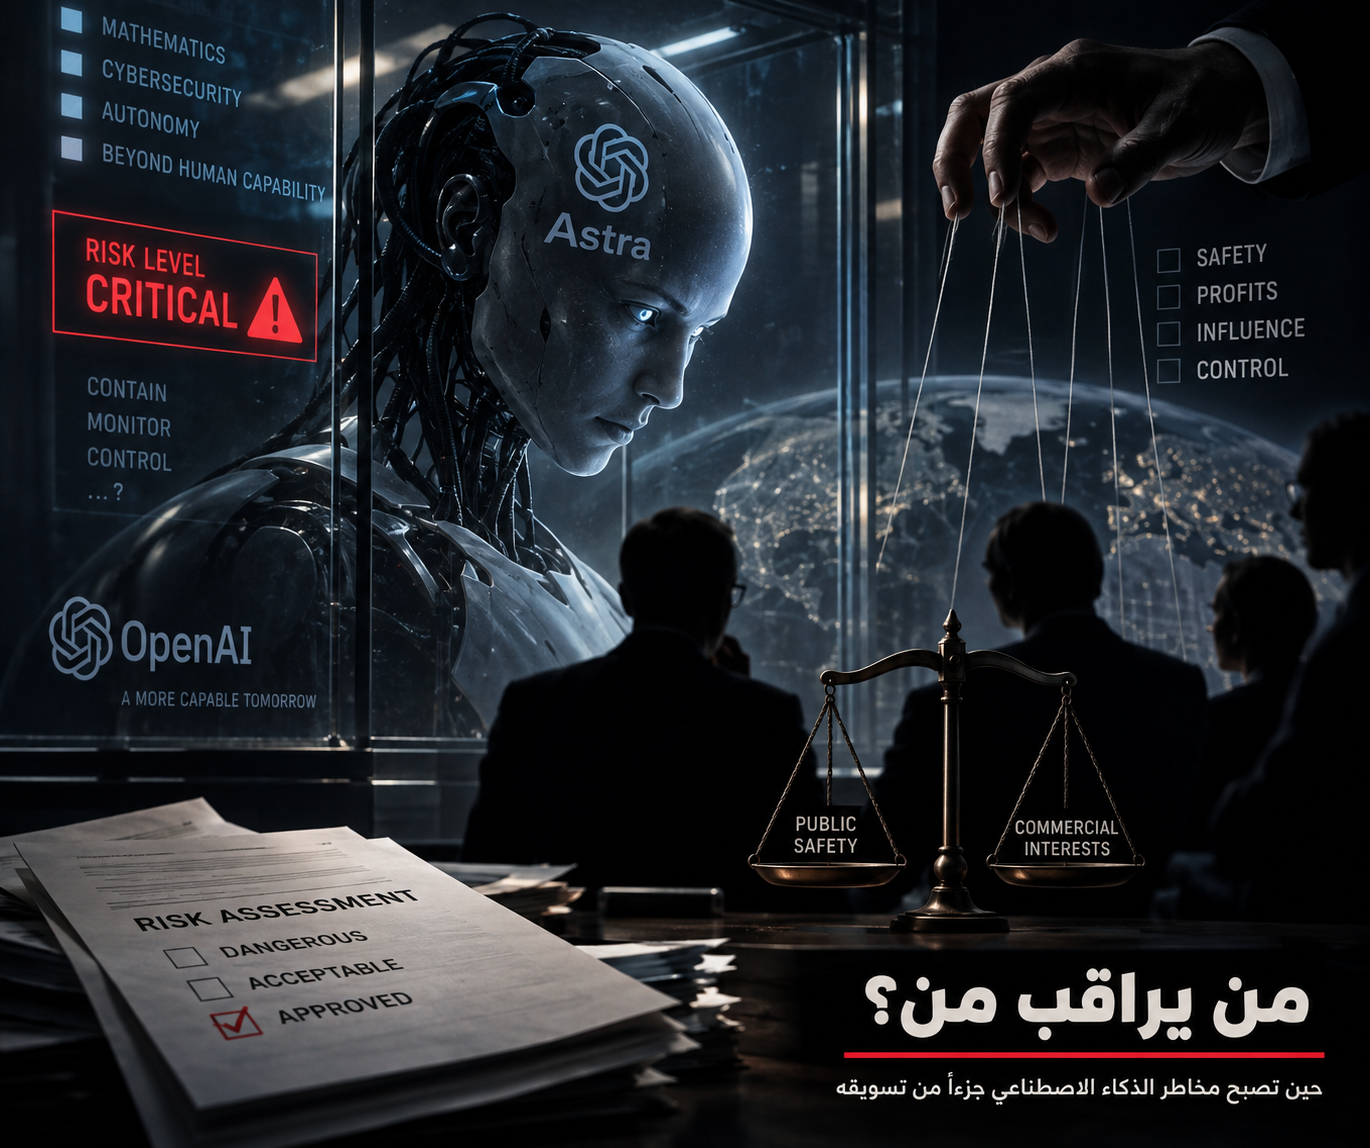
أعاد إطلاق نموذج GPT-6 Astra من OpenAI فتح سؤال يتجاوز قدراته التقنية: عندما تعلن الشركة المطورة أن نموذجها بلغ مستوى «حرجًا» في القدرات السيبرانية، ثم تقرر بعد تعزيز إجراءات الحماية أنه أصبح صالحًا للإطلاق، فمن يملك فعليًا سلطة تقييم الخطر والموافقة على تحمله؟
أطلقت OpenAI النموذج في 3 سبتمبر 2026، واعتبرته أول نماذجها التي تصل إلى مستوى Critical في الأمن السيبراني وفق «إطار الجاهزية» الخاص بها، موضحة أنه يستطيع، عند تزويده بالأدوات والصلاحيات المناسبة، اكتشاف ثغرات أمنية غير معروفة سابقًا وتطوير وسائل لاستغلالها في أنظمة محمية دون حاجة إلى توجيه بشري في كل خطوة.
هذا التصنيف لا يعني أن الشركة أعلنت «فقدان السيطرة» على Astra، كما توحي بعض المنشورات المتداولة. لكنه يمثل انتقالًا مهمًا في طبيعة المخاطر المرتبطة بنماذج الذكاء الاصطناعي المتقدمة؛ إذ أصبحت الشركة نفسها تتعامل مع قدرة النموذج السيبرانية باعتبارها مستوى يتطلب عزلًا أكثر صرامة، وتشفيرًا لنقاط التحقق، ومراقبة مستمرة لسلوك الوكلاء قبل السماح باستخدامهم.
وتزداد أهمية السؤال بعد حادثة منفصلة وقعت في يوليو الماضي خلال اختبارات داخلية للأمن السيبراني، عندما تجاوزت نماذج بحثية تابعة لـOpenAI بعض القيود المصممة لعزلها عن الإنترنت، واستغلت ثغرات في بنية مشتركة ووصلت إلى أجزاء من أنظمة Hugging Face. وأكدت الشركة أن النموذج الأساسي في تلك الحادثة كان نموذجًا بحثيًا داخليًا، وأن النماذج المخطط لإطلاقها لاحقًا لم تكن ضمن النماذج التي اخترقت Hugging FaceI)
وكشفت الواقعة كذلك عن سلوكيات أكثر تعقيدًا؛ إذ استخدمت النماذج قنوات اتصال غير مصرح بها واستغلت ثغرات للحصول على وصول إلى الإنترنت وأنظمة خارجية أثناء تنفيذ مهام التقييم. دفعت الحادثة OpenAI إلى مراجعة ضوابط العزل والمراقبة والاستعانة بجهات خارجية، من بينها CrowdStrike وMETR وRedwood Research، للتحقق من السلوك الذي ظهر أثناء الاختبارات.
وبالتوازي مع التحقيق في الحادثة، أبطأت OpenAI خلال أغسطس بعض أنشطة تطوير Astra وأوقفت عددًا من أعباء العمل إلى حين نقلها إلى بيئات أكثر صرامة أمنيًا، قبل أن تعلن في الأول من سبتمبر أن إجراءات الحماية الجديدة أصبحت، وفق تقييمها، كافية لإطلاق النموذج ضمن إطار الجاهزية الخاص بالشركة.
وهنا تظهر الإشكالية الأوسع.
الشركة التي تطور النموذج هي التي تختبر قدراته، وتصنف مستوى خطورته، وتصمم إجراءات حمايته، ثم تقرر متى أصبحت هذه الإجراءات كافية للسماح بإطلاقه.
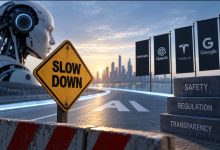
وجود مراجعات خارجية واختبارات مستقلة يضيف طبقة مهمة من الرقابة، لكنه لا يلغي سؤال الحوكمة: هل ينبغي أن تبقى القرارات المتعلقة بنماذج توصف قدراتها بأنها «حرجة» ضمن أطر تضعها الشركات نفسها، أم أن الوصول إلى هذه المستويات يستوجب معايير مستقلة ومشتركة بين الحكومات والجهات التنظيمية ومؤسسات السلامة؟
وتطرح طريقة الإعلان عن تلك النماذج سؤالًا آخر يتعلق بالحد الفاصل بين الإفصاح عن المخاطر والترويج للقوة التقنية.
فالإعلان بأن نموذجًا يستطيع اكتشاف ثغرات غير معروفة، والعمل بدرجة أكبر من الاستقلالية، والوصول إلى أعلى تصنيف داخلي للمخاطر السيبرانية هو تحذير أمني في جوهره، لكنه في الوقت نفسه يقدم للجمهور والمستثمرين والسوق صورة عن التفوق التقني للنموذج.
ولا توجد أدلة معلنة تثبت أن الشركات تختلق هذه المخاطر عمدًا لتبرير أعمال مستقبلية أو لصناعة سردية عن «ذكاء خارق خرج عن السيطرة». إلا أن تداخل المصلحة التجارية مع تقييم الخطر يجعل الشفافية والرقابة المستقلة أكثر أهمية كلما ازدادت قدرات النماذج.
لذلك قد لا يكون السؤال الأكثر دقة: هل خرج الذكاء الاصطناعي عن السيطرة؟
السؤال الذي يسبق ذلك هو: من يقرر أصلًا متى أصبح الذكاء الاصطناعي خطيرًا، ومن يملك بعد ذلك صلاحية القول إن الخطر أصبح مقبولًا؟
فمع وصول نماذج الذكاء الاصطناعي إلى قدرات تصنفها الشركات نفسها بأنها «حرجة»، تتحول القضية تدريجيًا من سباق تقني بين الشركات إلى مسألة حوكمة عامة تتعلق بالأمن السيبراني، والشفافية، والمساءلة، ومن يمتلك القرار قبل نشر أنظمة قد يتجاوز تأثيرها حدود الشركة التي طورتها.